把一份用户调研方法对照表原样丢给 AI,它连一份像样的问卷都出不来——问题多半不在模型,在资料的形态。这篇文章讲怎么把「一堆内容」重造成 AI 能直接执行的资料库:以用户调研为例,覆盖资料生成、内容设计、检查、迭代、关联五件事。
一、先拆:一份资料只讲一件事
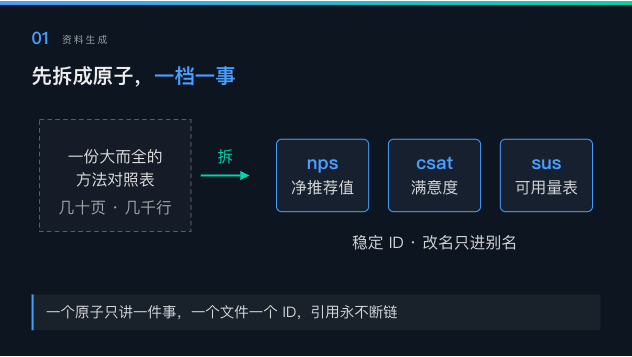
多数人手里的方法论资料,是一份几千行的对照表,或者几十页的文档。人读没问题,AI 读起来很吃力:它每次只能取其中一小段,取到的往往不是完整的方法,而是半截描述。第一步是把资料拆成「原子」——一个原子只讲一件事,一个原子就是一个文件。拿用户调研来说,NPS 净推荐值是一份,CSAT 满意度是一份,SUS 可用性量表又是一份,互不掺和。
拆的时候有条纪律:每个原子一个稳定 ID,一经发布永不改名。调研方法常有多个叫法——净推荐值、推荐值、NPS——改名只进「别名」字段,ID 不动。这样别的资料引用它时,永远不会断链。
还有一条容易被忽略:原文措辞要原样保留。NPS 的题干怎么问、几分制、后面接什么追问,照抄进「题目构成」一节。AI 生成问卷时直接抄用,而不是自己发挥——它一发挥,量表就变了味。
二、双层结构:索引管检索,执行管照做
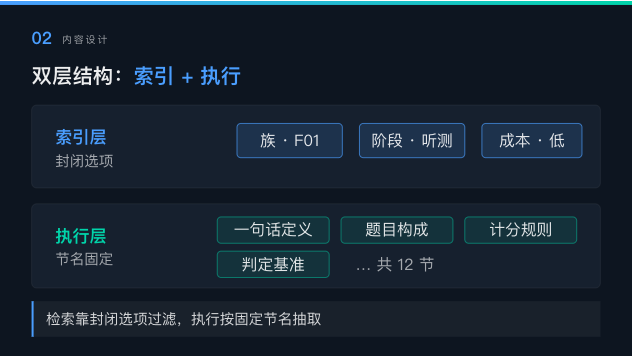
每份原子文件分两层。上层是索引层,字段全是封闭选项:属于哪个族(比如「满意度·忠诚度」族)、适用什么研究阶段、成本高低。为什么必须封闭选项?因为 AI 选方法靠过滤和聚合——「把听测阶段、低成本的关系类题目都列出来」,封闭选项才过滤得动,自由发挥的文本过滤不动。
下层是执行层,节名和顺序一字不改:一句话定义、理论背景、题目构成、计分规则、判定基准、适用场景、不适用与易混淆、陷阱与误用……固定下来,AI 才能按节名直接取用——「把计分规则那一节拿来」,不用通读全文再猜哪段在讲计分。
执行层里最值钱的,反倒是「负向约束」:什么情况别用这个方法、它和相邻方法怎么区分。CSAT 测单次触点,NPS 测整体关系,两个分数不能直接比——这种话写进「不适用与易混淆」一节。AI 最容易犯的不是不会用,而是用错场合。
再就是确定性优先。计分规则写成伪代码,末尾必须带一行算例:十个人作答,推荐者占五成、贬损者占两成,相乘相减,NPS 等于 30。判定基准写成数值表,68 分是行业均值。「通常较高」「一般来说」这类模糊话,不许出现在计分和判定里——模糊表述进了执行层,AI 就只能跟着模糊。
三、写完就查:让检查跑在交付前面
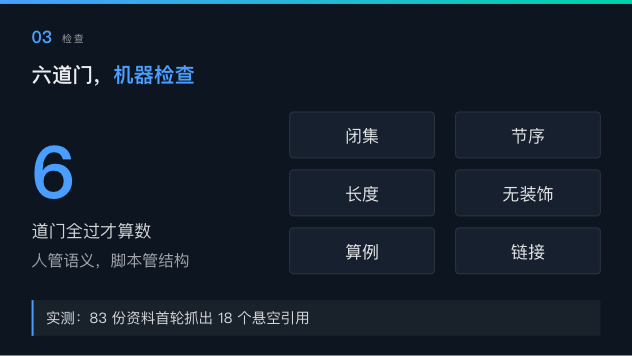
资料是给机器用的,检查也得机器来。每份文件要过六道程序化检查:字段是否齐全且都在闭集内、节序是否一字不差、有没有超长、有没有装饰符号、计分规则末尾有没有算例、引用链接是否有效。任何一道不过就打回,人只负责语义对不对,结构对不对交给脚本。
长度上限要对齐切片系统,比如 3800 字符——保证一份原子完整落在同一切片里,检索时不会取到半截。真超了也别硬砍,处理有个顺序。
第一步压缩措辞,丢形容词、不丢锚点。
第二步把细节下沉到更高层的文档。
第三步实在不行才拆成上下两篇,而且只在节与节之间切——任何一节都不许跨文件,否则切片取到的又是半截话。
出处还有条规矩:必须能独立理解。「见原表第 12 节」这种引用,在资料库里就是死链——库里的读者没有源文件。出处要写成真实的引用:作者、机构、作品、年份。
真跑一遍才知道检查值钱。八十三份调研方法迁进库,第一轮就抓出十八个悬空引用——资料里写着「组入某个方法」,那个方法压根不存在。这种问题人眼翻三天也翻不出来,脚本一秒。
四、资料是要长大的:状态与派生
资料库不是一次建完的。第一批批量生成时,很多字段源数据里没有——别名、成本、最低样本量,这些一律标草稿状态;人工补齐、检查通过,才升正式。状态写在文件头部,谁接手都知道哪份能用、哪份还没定稿。
索引不手改。检索入口和总目录是从全部文件的索引层自动生成的,每加一批资料就重建一次。手改一次,下次生成就被覆盖,还容易漏——派生的东西交给程序,人只写源头。
五、连起来:资料才成网络
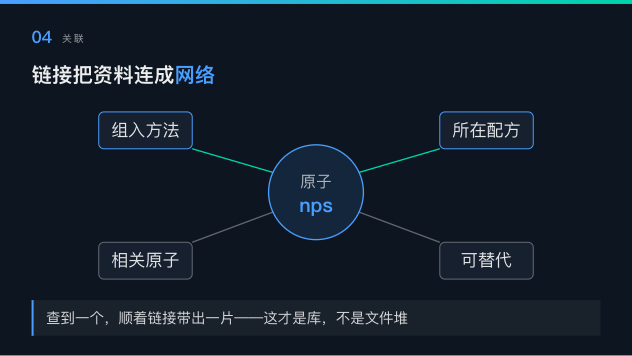
单份资料再规范,不连起来就只是一堆文件。原子引用方法——NPS 这个题目组入「忠诚度追踪」方法;方法组成配方——几个方法搭配解决一个研究问题;原子之间还有「相关」和「可替代」两种边。AI 查到一个方法,顺着链接能把配套题目、替代方案一次带出来,这才是资料库和文件堆的区别。
链接一律指向正式 ID;重名要用全路径区分——「nps」既是题目也是方法,写清楚指向哪个。最后生成一份纯文本的机器入口:每条路径配一句话定义。AI 检索时先看入口,再钻进具体文件。
说白了,这套方法的核心不是什么高深理论,而是把「给 AI 的资料」当成一种新的写作对象:生成时拆小、设计时分层、质量靠程序检查、生长靠状态标记、意义靠链接网络。结构对了,AI 才真的会用——它选得出方法、抄得对题目、算得对分数,也知道什么时候不该用。
评论
0 条登录后参与讨论。本站评论仅对注册用户开放(需站长审核注册),用于展示你的身份。